

准备更换模型或执行框架?Lab 帮助您用自己的工作案例衡量差异。在可比的上下文中比较模型与机制配置,再实际验证所选引擎的表现。这些评估不能替代对工具和外部效果的完整试用。选择模型与执行框架。
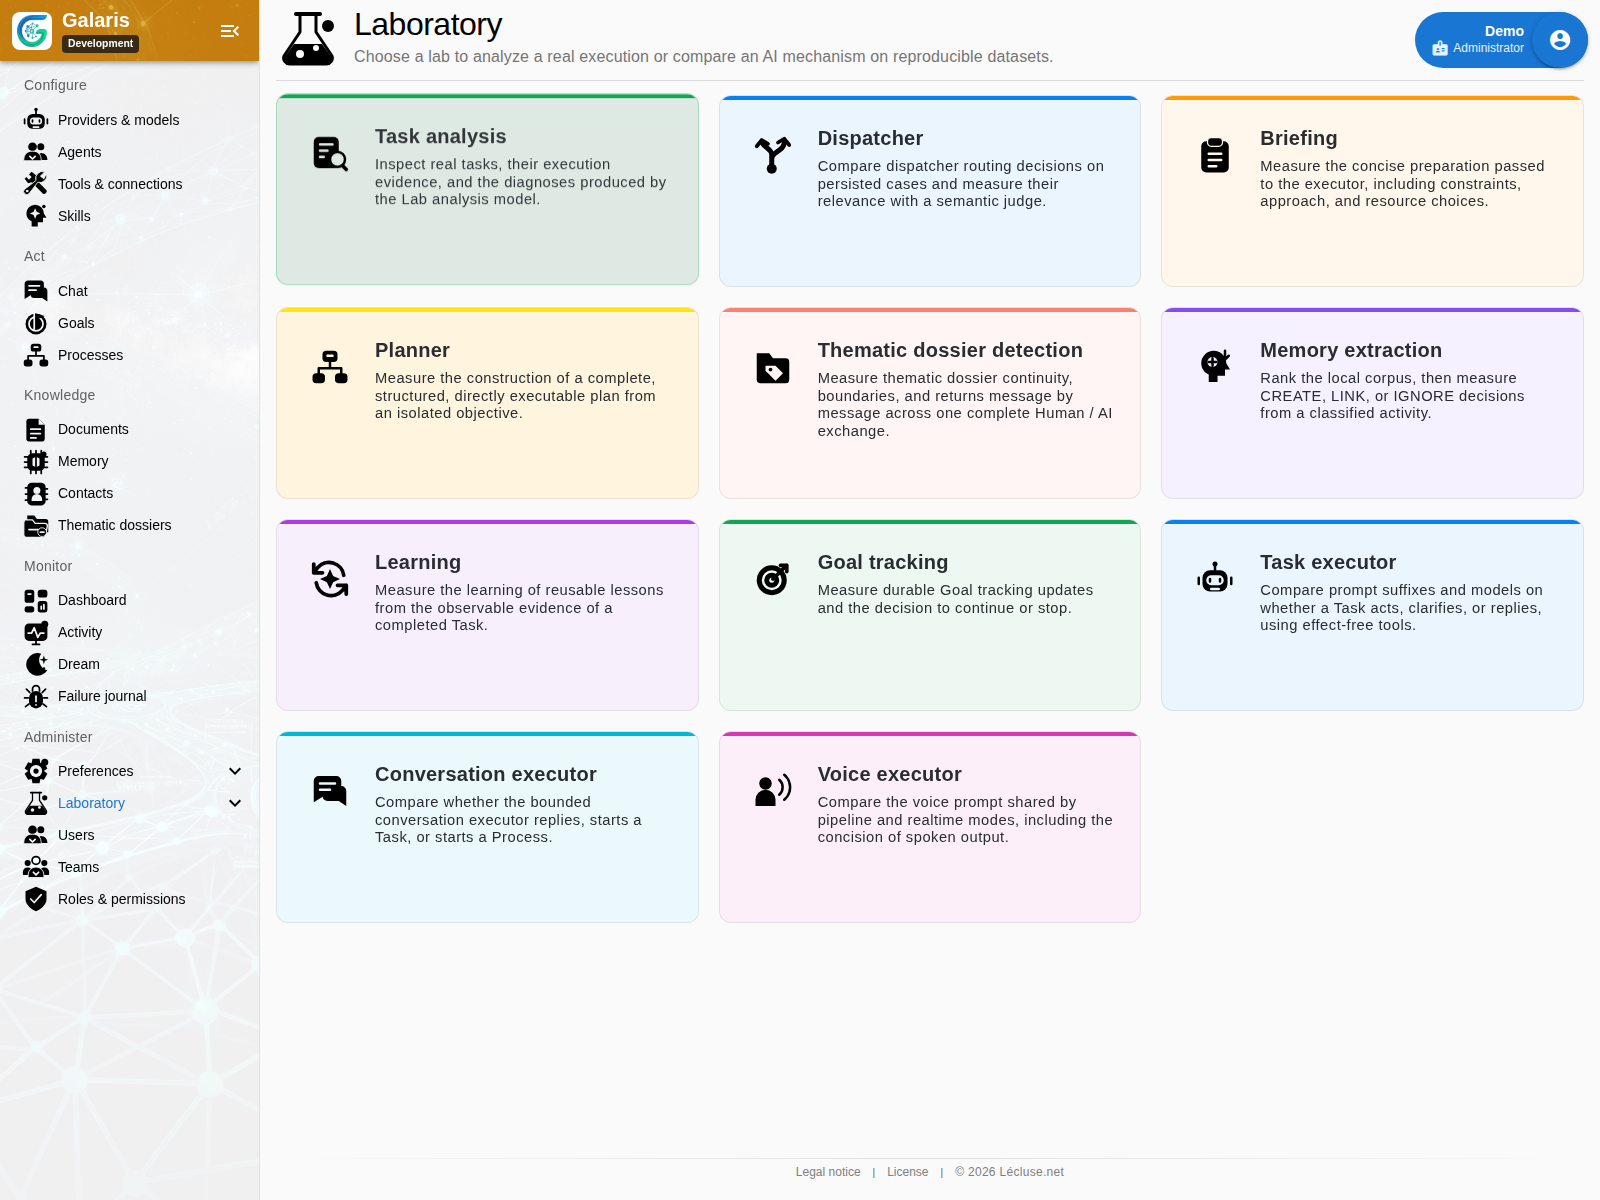
分别检查十种机制
| 类别 | 机制 |
|---|---|
| 工作准备 | Dispatcher、Planner |
| 整理与学习 | 主题检测、记忆提取、学习 |
| 跟进 | Goal 跟进 |
| 执行 | 任务、对话与语音执行器 |
| 诊断 | 任务分析 |
事件日志是独立界面。
围绕具体问题建立测试集
建立测试集时,可生成适合机制的 1 至 20 个合成案例,并按需结合实验上下文。案例带有预期结果与生成来源,作为待审阅草稿保存。生成未完整完成时,不会发布部分测试集。
按机制创建案例,包含测试变量、上下文和预期结果。可以收录带来源的任务、对话轮次或语音轮次。导入前可查看源配置与测试集参数的差异。
区分工作集、验证集和保留集。案例类别包括常规、歧义、上下文不完整、多语言、稳健性、真实事件或其他有效答案。不完整案例仍为草稿;模型提出的参考答案需要复核。
先执行,再评判
候选模型与评判模型分别选择。启动时固定案例、参数和模型。第一轮产出结果和客观检查,第二轮评判;候选模型不会收到预期答案。
各维度评分、理由、关键失败和未评分案例可以查看。活动结束不等于全部成功;评判模型失败时评分保持缺失。
测量稳定性并恢复评估
每个条目可重复 1 至 20 次,比较成功率、均值、极值和离散情况。取消时保留已发布结果;可按原快照继续剩余案例,也可直接重新评判已有输出,无需再次调用候选模型。
可选预算用于接纳候选和评判的新阶段。重复测试只衡量这些案例上的稳定性,不代表所有未来情况。
比较调整前后的结果
十种机制均支持比较两次评估,包括来自不同数据集的评估。Galaris 按相同输入、参考答案和重复轮次配对,并排展示输出、标准、成本和耗时,移动端则上下排列。汇总覆盖完整运行。配对歧义或不兼容配置会阻止产生误导性的改进结论。
待检查的退步突出新增严重失败、由成功变为失败的案例及共同标准上的差异。延迟、成本和质量展示中位数与有效配对数量,包括排除排队和评审时间后的首次输出延迟。缺失测量和评分保持缺失。
比较只使用已记录结果,不发起推理,也不更改生产设置。新增结果或评审后需重新比较。它帮助您检查具体案例上的变化,本身不证明统计上的优越性。
汇总分别统计独立案例、重复运行、可比较的配对、缺失输出、未评判结果和错误。重复同一案例不会产生多个独立案例;缺失输出不会被视为零分。
加入独立人工评审
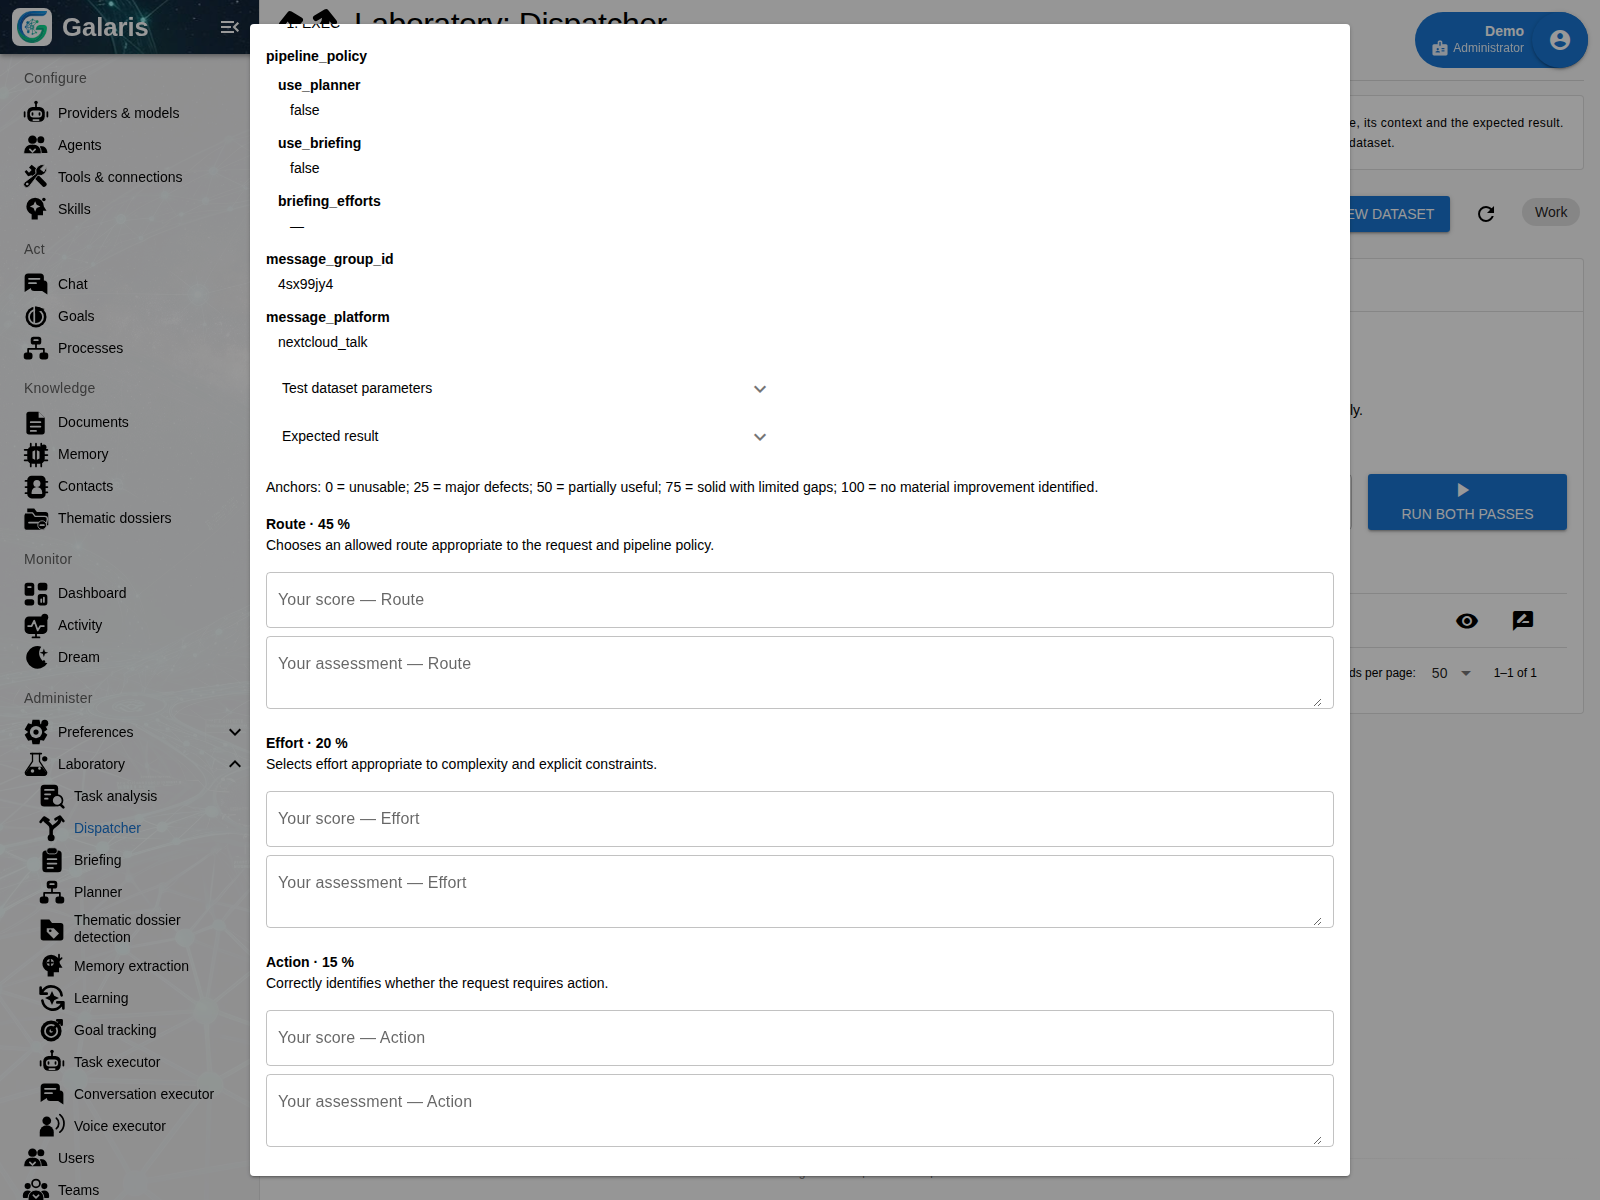
评审可隐藏模型身份与自动评分。每人先打分并说明理由,再揭示自动判断,便于查看分歧。已揭示的评审固定保存;重新评判创建新的活动。
与智能体一起准备和分析实验
启用 Galaris Lab 连接后,智能体可通过实验室的 50 个 MCP 函数准备测试集、运行评估、比较结果并检查证据。它操作的实验与您在界面中看到的相同,耗时分析也有可查看的进度。
该连接默认关闭。Galaris Lab 技能可以指导操作,但不替代权限;收录和诊断实际工作还需要管理检查权限。修改实验不会改变生产环境的提示词或模型。
智能体评审保留作者身份,与人工评审及自动评判分开。您可以让它协助分析,同时保留自己的判断。
把问题变成检查案例
结合人工上下文分析任务档案,无需重新执行任务。也可收录诊断,评估分析机制本身。
模拟工具不会证明真实外部效果。语音 Lab 评估转写文本,不测量 STT/TTS 声学质量。事件跟踪 为评估提供补充。
评估实际允许的选择
Dispatcher Lab 检查框架允许的模式,并保留确定性决策及其理由。Lab 的十项评估机制与 Dream 的十四项后台机制是不同目录。