

Vous envisagez de changer de modèle ou de harnais ? Le Lab aide à mesurer les écarts sur vos cas de travail. Comparez les modèles et les configurations des mécanismes à contexte comparable, puis vérifiez le comportement du moteur retenu en situation. Ces évaluations ne remplacent pas un essai complet des outils et des effets externes. Choisir les modèles et les harnais.
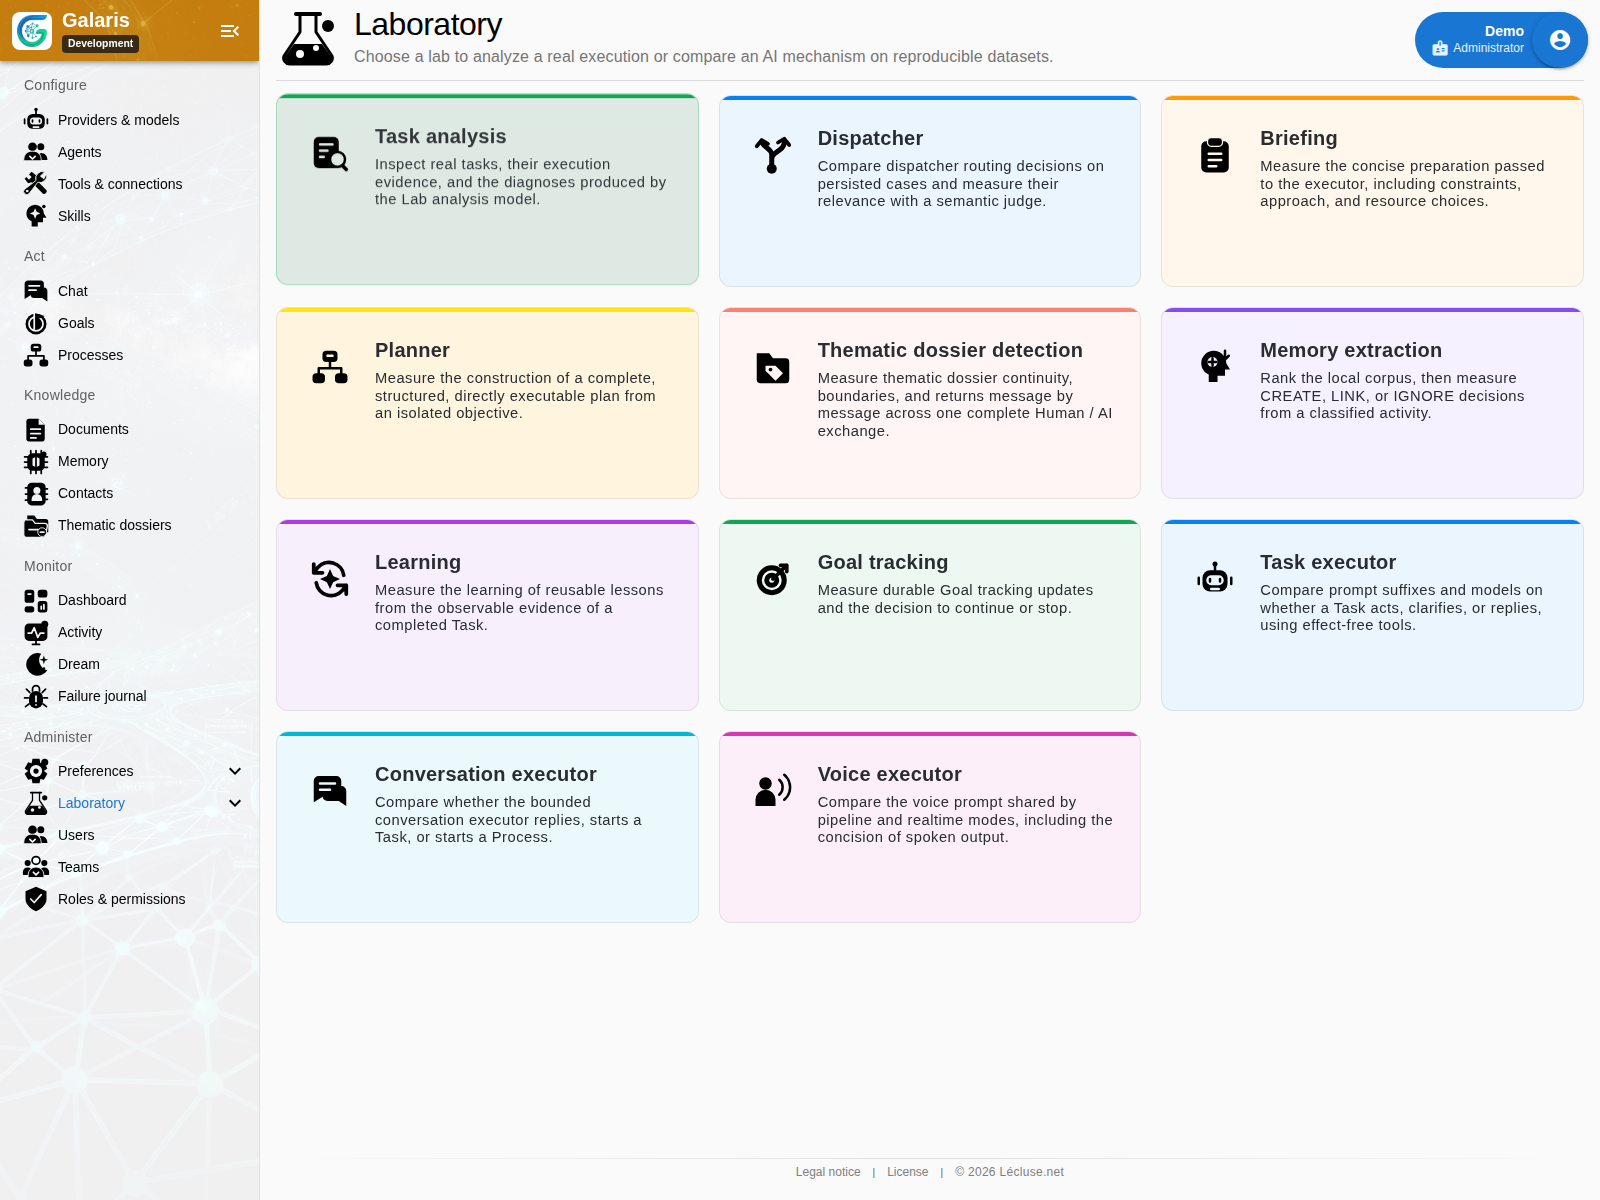
Dix mécanismes à examiner séparément
| Famille | Mécanismes |
|---|---|
| Préparer le travail | Dispatcher, Planner |
| Organiser et apprendre | Détection des sujets, extraction mémoire, apprentissage |
| Suivre | Suivi de Goal |
| Exécuter | Exécuteur de tâches, conversationnel, vocal |
| Diagnostiquer | Analyse de tâches |
Le journal d’incidents est une surface distincte.
Construire un jeu qui répond à une question
Pour amorcer un jeu, générez 1 à 20 cas synthétiques adaptés au mécanisme et, si vous le choisissez, au contexte de l’expérience. Ils sont enregistrés comme brouillons à relire, avec leurs attentes et leurs sources de génération. Une génération incomplète ne publie pas un jeu partiel.
Créez des cas propres au mécanisme, avec variable testée, contexte et attendu. Une tâche, un round ou un tour vocal peut être capturé avec sa provenance. Les écarts entre configuration source et paramètres du jeu sont visibles avant import.
Séparez les jeux de travail, de validation et de réserve. Classez les cas : nominal, ambiguïté, contexte incomplet, multilingue, robustesse, incident réel ou alternative valide. Un cas incomplet reste brouillon. Un attendu proposé par modèle demande une revue.
Exécuter puis juger
Le candidat et le juge sont sélectionnés séparément. Le lancement fige cas, paramètres et modèles. La première passe produit les sorties et contrôles objectifs ; la seconde les juge. Le candidat ne reçoit jamais l’attendu.
Les scores par dimension, justifications, échecs critiques et cas non jugés restent consultables. Une campagne terminée n’est pas nécessairement réussie ; une panne du juge laisse une note absente.
Mesurer la stabilité et reprendre une campagne
Répétez chaque item de 1 à 20 fois pour comparer taux de réussite, moyenne, extrêmes et dispersion. Annulez en conservant les résultats publiés, reprenez les items restants avec le snapshot ou rejugez les sorties sans rappeler le candidat.
Un budget optionnel couvre candidat et juges pour l’admission des nouvelles étapes. Les répétitions mesurent la stabilité sur ces cas, pas toutes les situations futures.
Comparer avant et après un changement
Les dix mécanismes permettent de comparer deux évaluations, y compris issues de jeux distincts. Galaris rapproche les mêmes entrées, références et répétitions pour présenter sorties, critères, coûts et durées côte à côte, ou empilés sur mobile. Le bilan couvre les campagnes complètes. Une ambiguïté d’appariement ou une configuration incompatible empêche de conclure à un progrès trompeur.
Régressions à examiner repère les nouveaux échecs critiques, les cas passés de réussite à échec et les écarts par critère commun. Délai, coût et qualité expose les médianes et le nombre de paires disponibles, dont le délai de première sortie observée hors file d’attente et juge. Une mesure ou une note manquante reste absente.
La comparaison exploite les résultats enregistrés, sans lancer d’inférence ni modifier les réglages de production. Relancez-la après de nouveaux résultats ou jugements. Elle aide à examiner un changement sur vos cas ; elle ne démontre pas à elle seule une supériorité statistique.
Le bilan distingue les cas uniques de leurs répétitions, les paires comparables, les sorties manquantes, les résultats sans jugement et les erreurs. Répéter un cas ne crée pas autant de cas indépendants ; une sortie manquante ne devient pas un score nul.
Ajouter un regard humain indépendant
La revue peut masquer modèle et notes automatiques. Chaque personne note et justifie sa décision avant révélation ; les désaccords deviennent visibles. Une revue révélée est figée, un rejugement ouvre une autre campagne.
Préparez et analysez vos essais avec un agent
Autorisez la connexion Lab Galaris pour qu’un agent puisse préparer des jeux, lancer des évaluations, comparer les résultats et examiner les preuves avec les 50 fonctions MCP du laboratoire. Il travaille sur les mêmes expériences que vous dans l’interface. Les analyses longues disposent d’un suivi consultable.
La connexion est inactive par défaut. La compétence Galaris Lab peut guider l’agent, mais ne remplace pas ses droits ; les captures et diagnostics de travaux réels demandent aussi les accès d’inspection administrative. Modifier une expérience ne change pas les prompts ni les modèles de production.
Un avis d’agent garde son identité et reste distinct de la revue humaine et du juge automatique. Vous pouvez donc demander de l’aide pour explorer les résultats tout en gardant votre propre évaluation.
Transformer un incident en cas de contrôle
Analysez le dossier d’une tâche avec du contexte humain, sans rejouer son exécution. Capturez ce diagnostic si vous voulez évaluer le mécanisme lui-même.
Les outils simulés ne prouvent pas un effet externe. Le Lab vocal travaille sur une transcription et ne mesure pas la qualité acoustique du STT/TTS. Les incidents et leur suivi complètent cette évaluation.
Évaluer les choix réellement autorisés
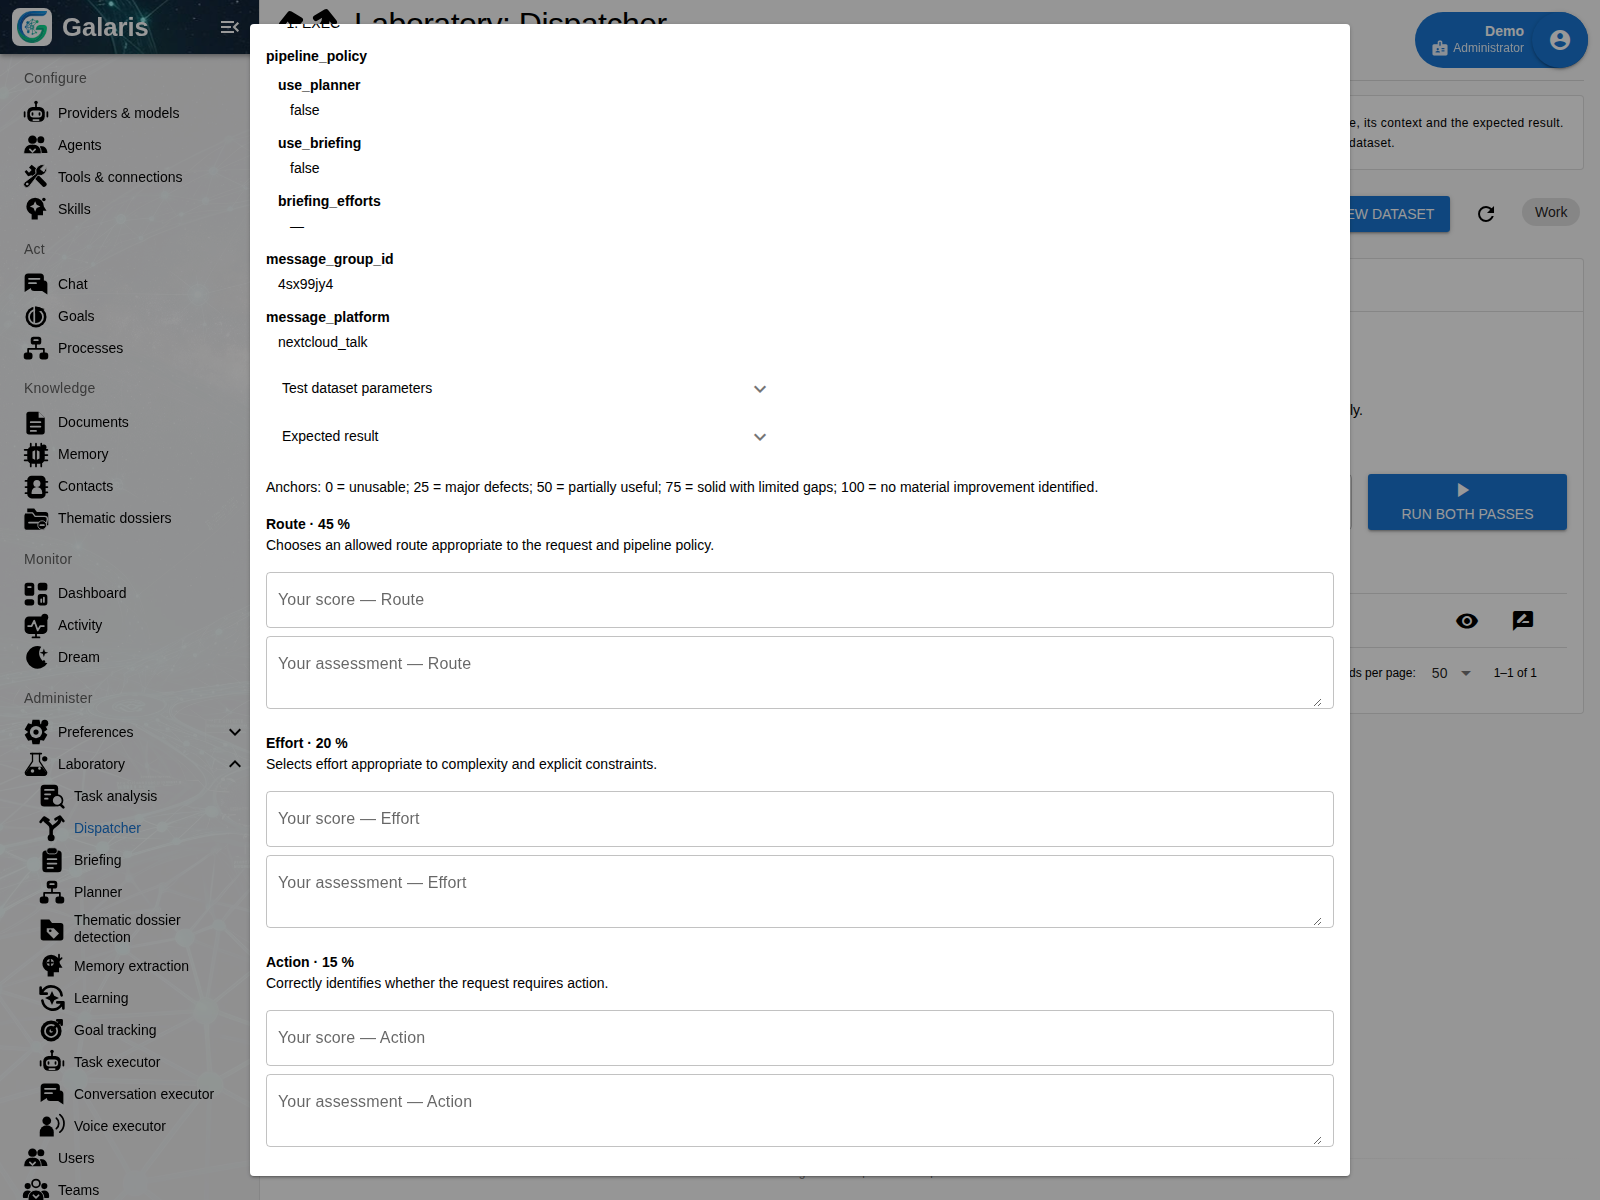
Le Lab Dispatcher examine les modes permis par le harnais et conserve les décisions déterministes ainsi que leurs motifs. Les dix mécanismes évaluables du Lab sont distincts des quatorze mécanismes de fond de Dream.