

模型、配置与执行框架
供应商提供推理资源;模型承担具体用途;配置组织这些选择。执行框架只运行 Task,不接收对话轮次。聊天使用内部控制器和对话模型资源。
四个文本层级及专用资源
| 层级 | 用途 |
|---|---|
| Ultra low | 需要模型的 Dream 机制 |
| Low | Dispatcher 和对话 |
| Standard | 标准执行和 Goal 跟进 |
| High | 高复杂度执行、Planner 和 Lab |
推理强度单独设置。视觉、文档、嵌入、图像、转写、音视频分析和媒体生成分别选择资源。语音在智能体或用户上配置。
明确选择的配置具有排他性:缺少资源时,不会暗中从其他配置借用。未指定配置的智能体或用户跟随当前配置。
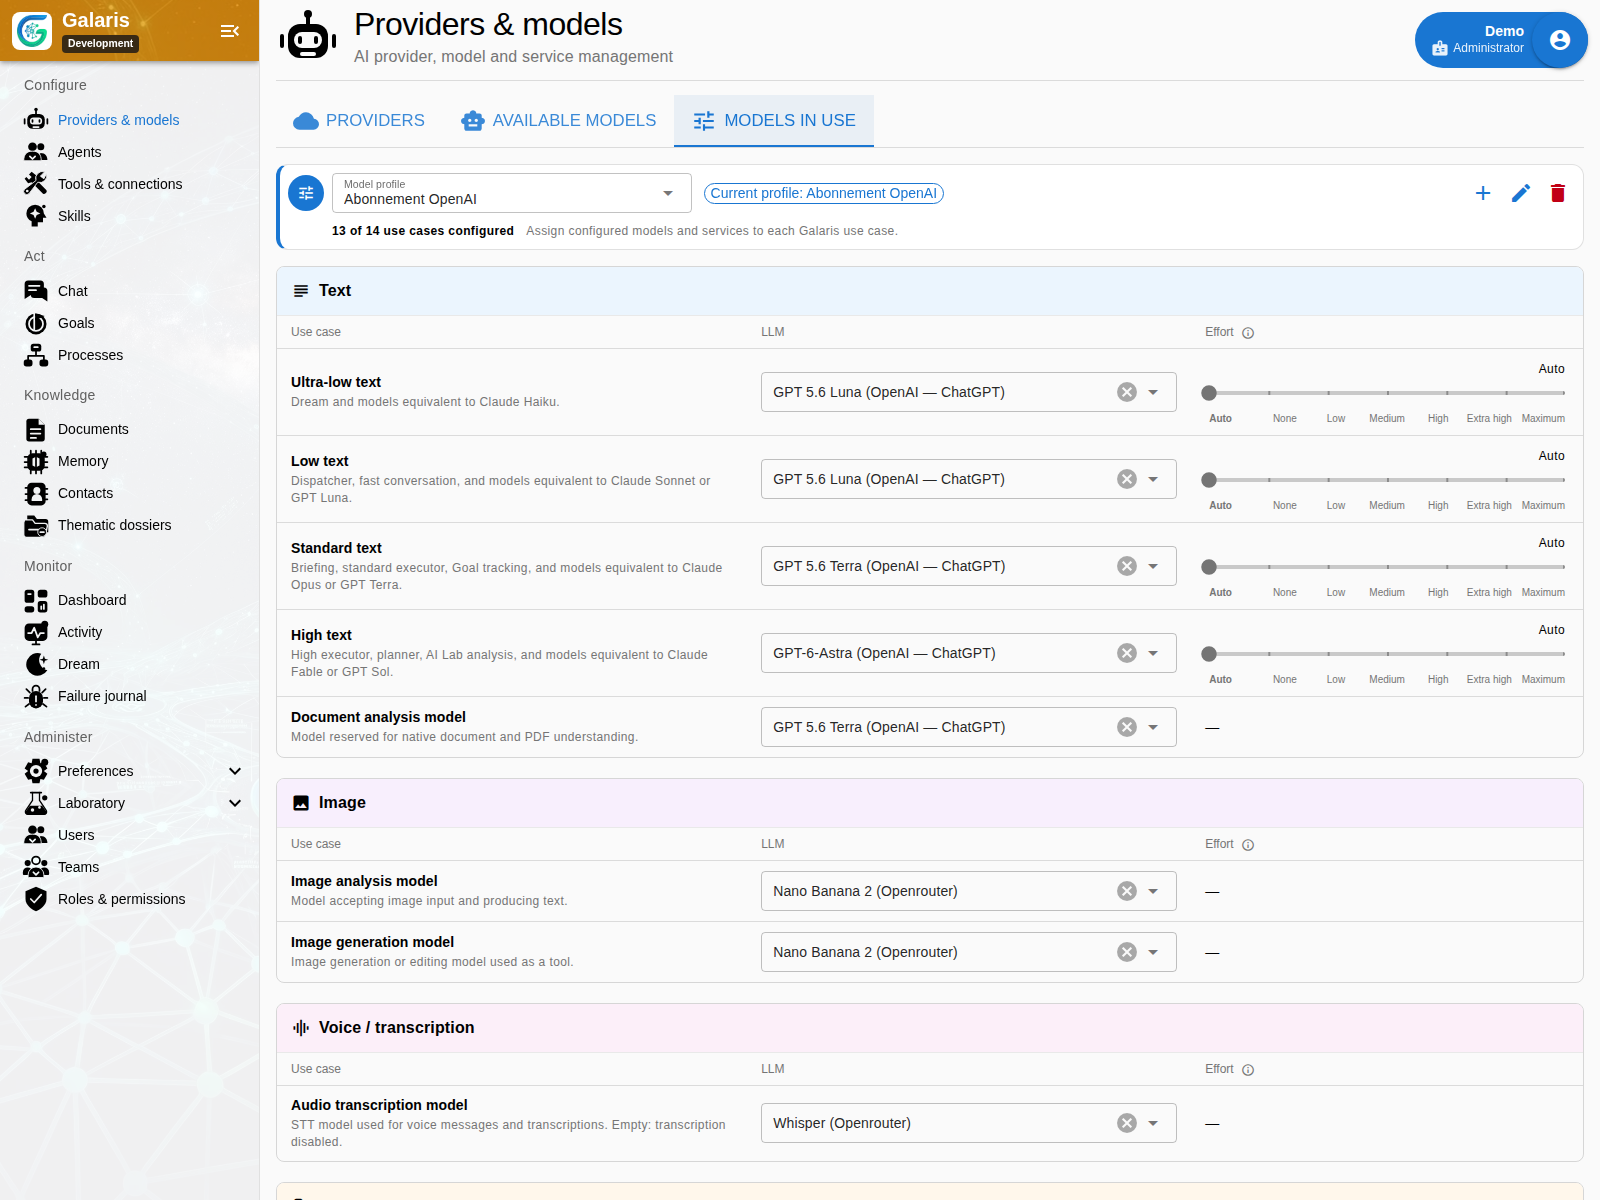
用于明确选项的决策模型
决策资源支持 TypeSafe 的 Jev 等专用模型;OpenRouter 预配置已选择 Jev。它与四个文本层级互补,从预先定义的选项中做出选择:Dispatcher 选择允许的执行路径与推理力度,分类机制复用候选主题或请求新主题,记忆保留机制则选择忽略、关联或提取。
Galaris 验证问题、返回的选项以及实际提供的概率。配置决定发生可恢复的不可用情况时是否回退到文本模型:尝试有次数边界,原因会记录,也不会凭空生成置信度。决策模型引导工作,操作仍受 Galaris 权限约束。深入了解这些内部机制。
您可以刷新已发现的模型能力,按资源类型或文档能力筛选目录,为每种用途选择合适资源。
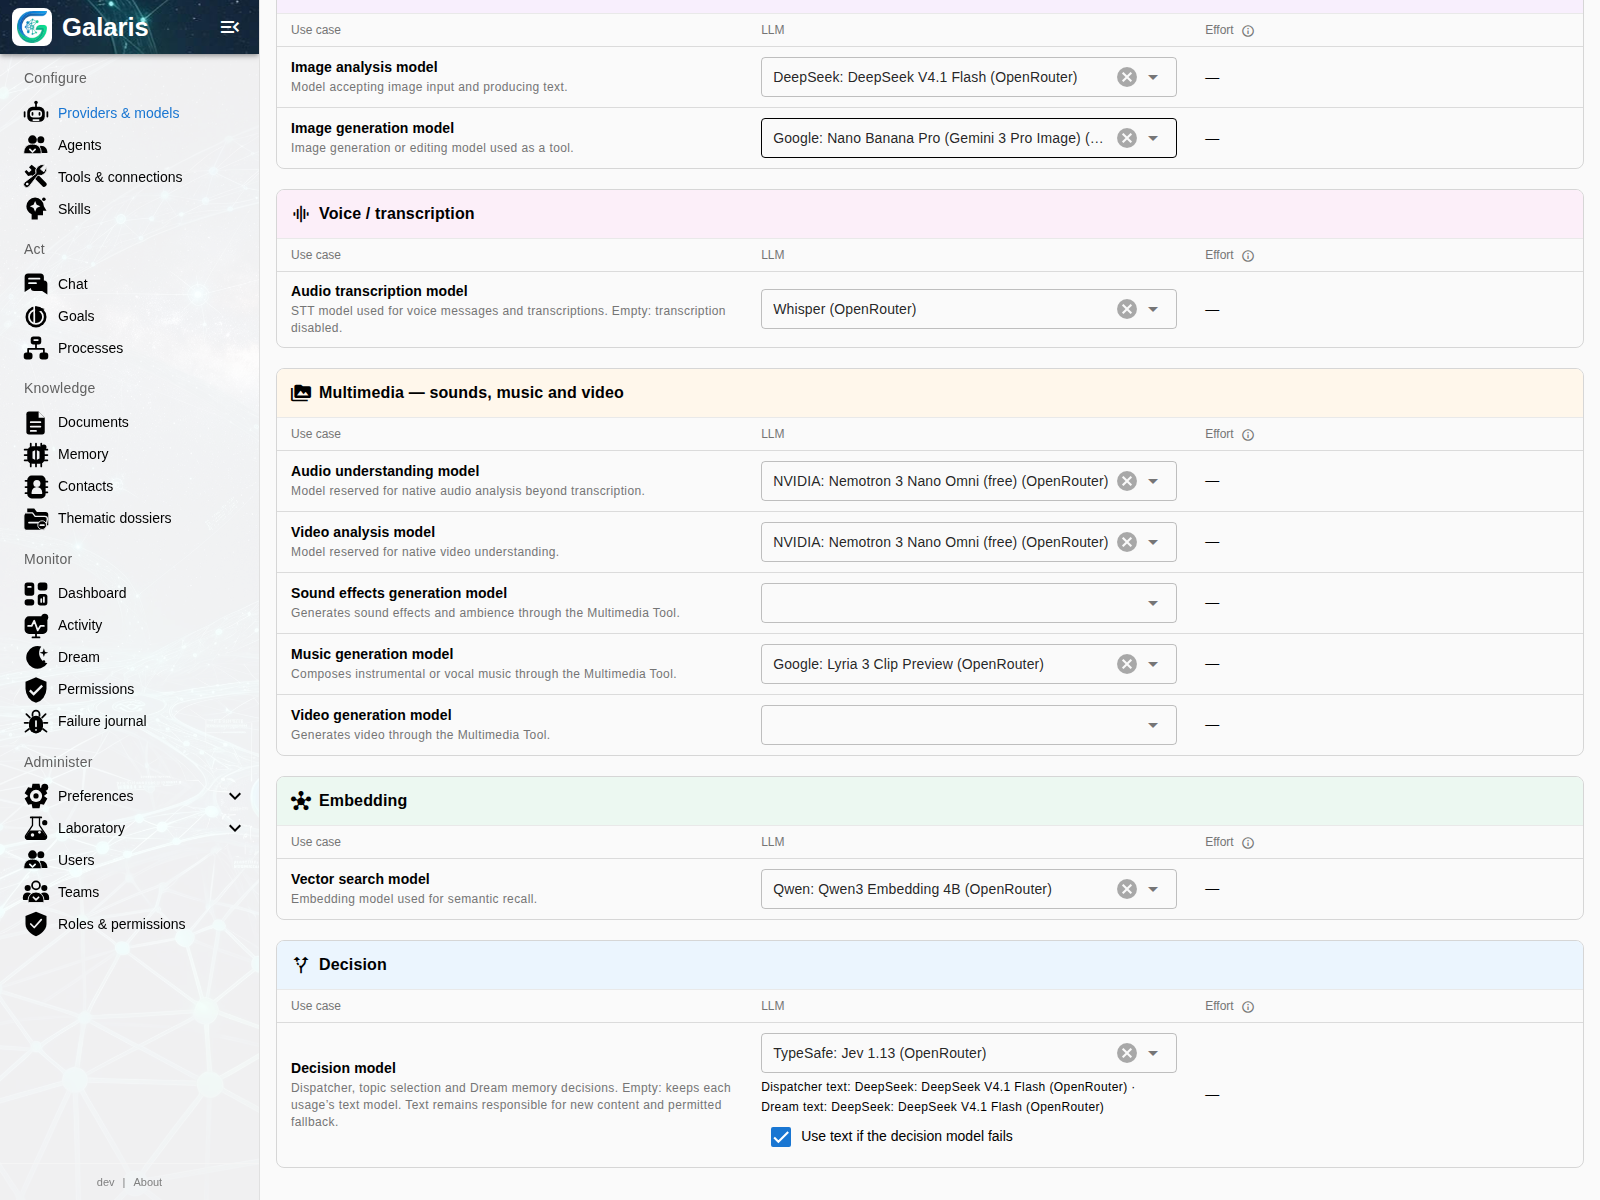
连接并管理供应商
全新安装已预设 OpenRouter、九个模型和用途配置。填入 API 密钥即可与 Galaris 助手交流,之后可修改选择、改用其他供应商或删除预设。已有配置的实例不会被强制添加供应商。尚未选择的资源,例如特定音色或音频生成,可按需要配置。
对于支持的个人 ChatGPT 连接,订阅面板显示可获取的使用周期、已用比例和重置时间。这些限制针对供应商账号整体,而非仅针对通过 Galaris 的调用;无法获取的信息会明确标示。
测试连接、发现模型并选择要使用的资源。目录可保留模态、上下文和已知价格;未知费用不会被视为零。Ollama 还支持其适配器提供的模型管理。
| 类别 | 已有集成 |
|---|---|
| 按资源提供文本与多模态 | OpenAI、Anthropic、Gemini、OpenRouter、Mammouth AI、DeepSeek、Fireworks、Groq、Mistral |
| 其他推理目录 | Together、Cerebras、xAI、NVIDIA、Hugging Face、Cohere、Perplexity |
| 语音与媒体 | ElevenLabs、Google Cloud TTS、Azure Speech、SunoAPI.org、BytePlus LAS |
| 本地模型与元数据 | Ollama;models.dev 用于补充目录信息 |
实际账号、模型和模态取决于供应商。支持的个人设备码认证仍绑定其所属用户。
网关依据供应商及端点约定调整参数。生成前明确拒绝某个可选设置时,可以仅移除该设置并进行有限重试。超时或部分输出不会触发移除;消息、工具、预算与输出格式保持不变。
选择每个智能体的执行框架
| 框架 | 在 Galaris 中的用途 |
|---|---|
| 内部 Pydantic AI | 原生执行、规划、按需工具与副作用检查点 |
| Hermès | 每智能体独立运行环境,共用记忆并投射技能 |
| Claude Agent | 每智能体 SDK,Anthropic 网关及 Galaris MCP |
| Codex | 受管理运行环境,工具与遥测适配共同约定 |
| DeepSeek Harness | DSH 实例,适配执行及流式输出 |
| 兼容 Chat Completions 的远程服务 | 配置 URL、模型、认证和服务声明的能力 |
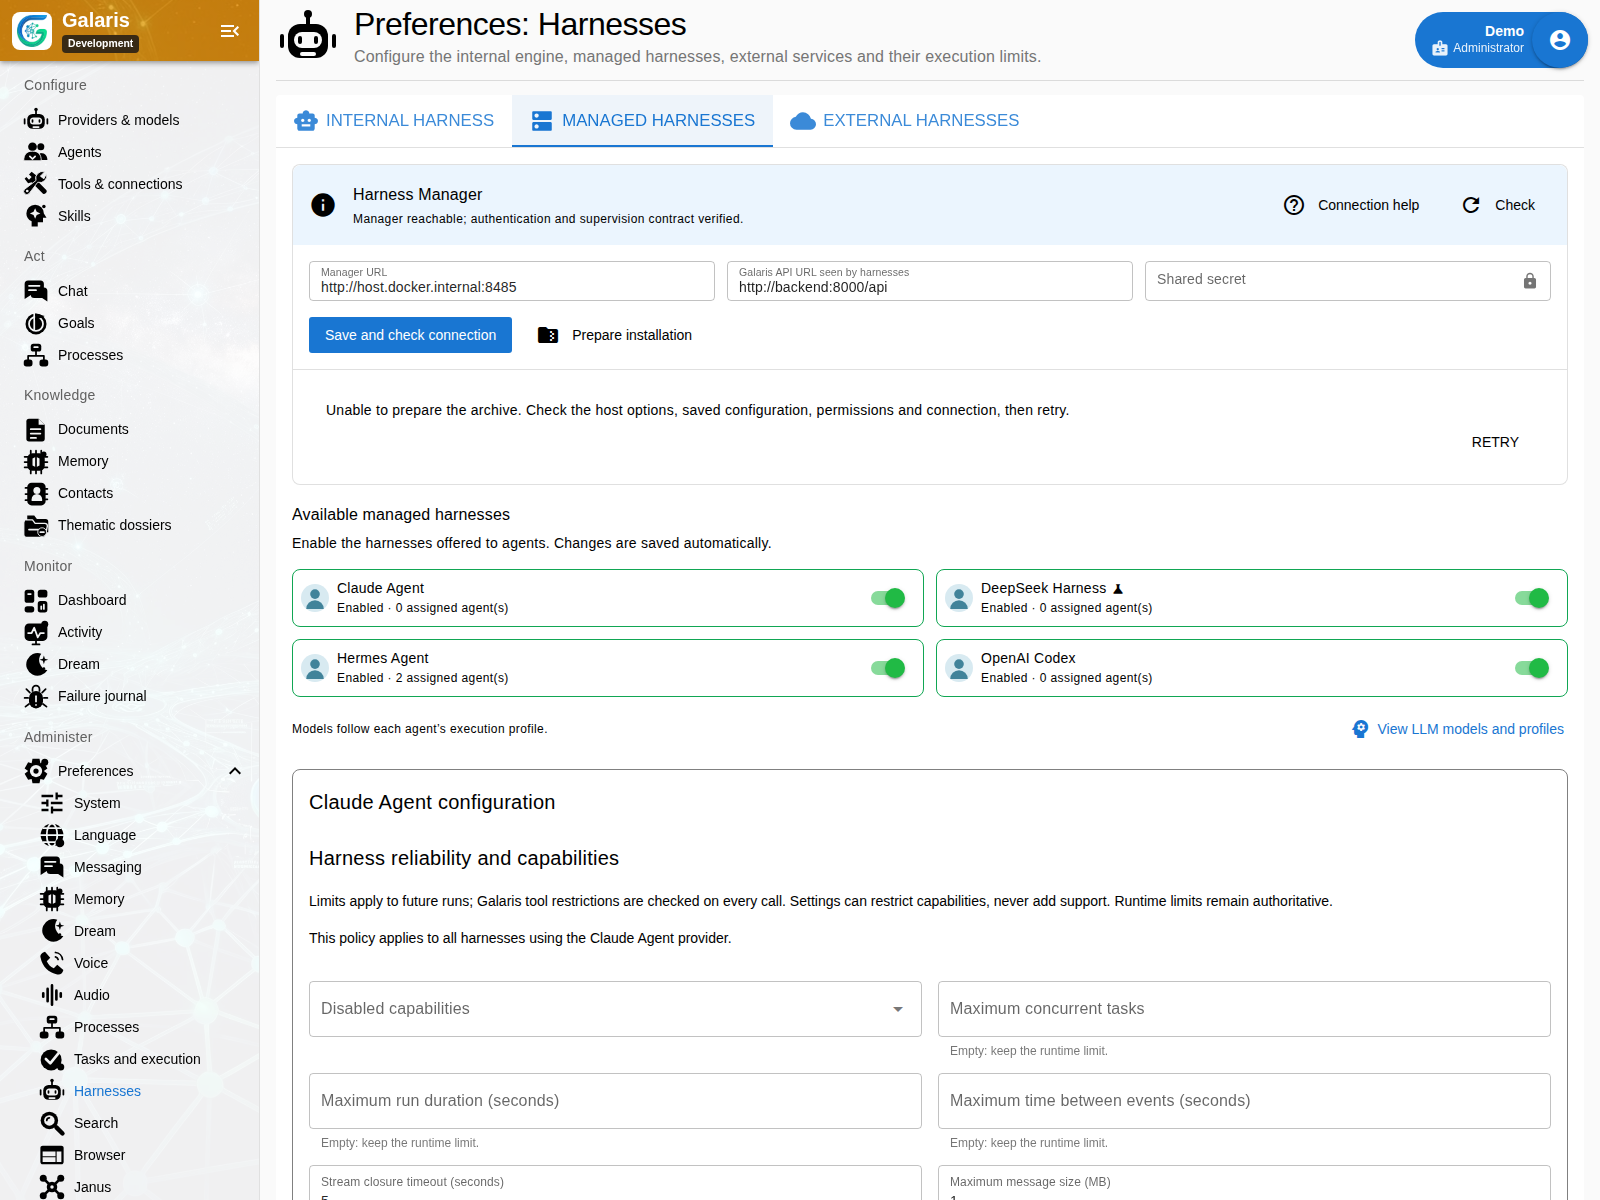
管理生命周期
根据适配器能力查看状态、错误、日志和文件,创建、启动、停止或更新运行环境。耗时操作有跟踪记录,未结束任务可能阻止环境变更。
选择容器化框架不会自动完成部署。当前外部适配器每实例同时接纳一个运行。内部框架的恢复保证不会自动扩展到所有适配器。
选择执行框架实际支持的模式
三种模式为 EXEC(标准执行)、EXEC high 和 PLAN(使用 high 级别进行规划),具体可用性取决于执行框架的能力。
| 执行框架 | 可用模式 |
|---|---|
| 内部框架 | standard 执行、high 执行、high 计划 |
| 托管 Hermès、Codex、Claude Agent、DeepSeek Harness | standard 与 high 执行 |
| 通用兼容服务器 | standard 执行 |
四种托管运行时目前使用 Galaris 模型网关。SDK 自带推理选项不等于可以启用 high 执行。Dispatcher 只在允许模式中选择;只有一个选项时无需调用模型路由。
管理员按供应商设置策略与限制。实际能力由实现、配置和目标验证共同决定。请求停止与确认远程已停止是不同状态。
个人 ChatGPT 连接需要记录所有者的明确同意。撤回同意后,即使认证仍连接,也会阻止调用。
内部引擎的原生多模态输入
在使用内部引擎的聊天与 Task 中,图片、音频、视频和 PDF 附件可以直接提供给模型。是否支持取决于模型声明的能力、MIME 类型以及传输层实际能够序列化的格式。
音视频输入通过兼容协议使用同一模型;视频需要已声明的提供方适配器。此能力不会自动扩展到外部执行框架。系统检查权限、大小与总预算,并向模型说明拒绝或格式不兼容的原因。媒体处理详情。
为模型回答留出空间
对于没有明确预算的 Chat/Responses 调用,Galaris 在估算的剩余上下文内使用模型公布的输出容量。明确预算优先;容量未知时使用供应商默认值。上下文压缩和远端保存的 Responses 历史遵循各自规则。因模型上限而截断的输出本身不能使任务通过验证。
先衡量差异,再做选择
更换模型或执行框架时,应结合自己的工作场景进行评估。Lab 可在相同案例上比较模型与机制配置的结果、稳定性、耗时及可获取的费用。还需结合所选执行框架的工具与实际能力进行试用。
更换引擎,连接仍保留在枢纽中
Hermes Agent、DSH(DeepSeek Harness)、Codex、Claude 和内置执行框架可以使用智能体的已授权工具。在 Galaris 中配置 MCP 服务器与功能,引擎获得适合其权限和执行上下文的工具集合。各引擎的能力和恢复方式仍有所不同。
例如,Telegram 承载请求,Hermes 执行任务,而在 Galaris 中配置的 Notion MCP 提供页面操作。选择引擎不意味着必须使用特定聊天界面或文档空间。查看组合方式与前置条件。
探索与 Galaris 兼容的生态系统:推理供应商、消息渠道、执行框架与服务,以及各项目的网站链接。
配置供应商并查看余额
连接测试成功后,供应商配置自动保存;后续相关字段变化也会保存。密钥始终隐藏:空输入保留密钥,新值替换密钥,删除需要确认。删除必需密钥会停用供应商。
用量与额度显示支持供应商的已知信息:ChatGPT、ElevenLabs、Mammouth AI、OpenRouter、DeepSeek 和 SunoAPI.org。面板说明单位及账号或密钥范围,在打开、手动请求以及保持打开时每五分钟刷新。缺失值不会变成零;余额并非每个智能体的预算。
各引擎共用的文档读取
PDF、Office、文本、HTML、Markdown、EPUB 和图像根据可用格式与转换器使用共同的文档准备机制。对于大型来源,document_analyze启动私有分批分析,document_analysis_get读取覆盖范围与结果,document_analysis_cancel请求停止。使用模型方案的文档模型,缺失时回退到标准文本模型。这些分析独立于业务流程。使用文档。